AI 功能配置指南
本指南将帮助您配置 AI 功能,包括 AI 智能匹配、AI 识别增强、AI 别名验证等功能。
📋 AI 功能概览
| 功能 | 说明 | 使用场景 |
|---|---|---|
| AI 智能匹配 | 使用 AI 从多个搜索结果中选择最佳匹配 | 当搜索结果有多个相似项时,AI 帮助选择最准确的一个 |
| AI 季度映射 | 使用 AI 从元数据源搜索结果中选择正确的季度 | 多季度剧集匹配时,AI 帮助识别正确的季度编号 |
| AI 识别增强 | 使用 AI 从文件名中提取结构化信息 | 当文件名格式复杂或不规范时,AI 帮助识别标题和季度信息 |
| AI 别名验证 | 使用 AI 验证和分类别名 | 验证别名是否真正属于该作品,识别语言类型(中文/英文/日文/罗马音) |
| AI 别名扩展 | 使用 AI 生成可能的别名 | 当元数据源返回非中文标题时,AI 生成中文译名、罗马音等别名用于搜索 |
🤖 支持的 AI 提供商
1. DeepSeek (推荐)
特点:
- ✅ 性价比最高的国产大模型
- ✅ 支持余额查询
- ✅ 响应速度快
- ✅ 中文理解能力强
如何获取 API Key:
- 访问 DeepSeek 官网
- 注册并登录账号
- 进入 "API Keys" 页面
- 点击 "Create API Key"
- 复制生成的 API Key (以
sk-开头)
配置示例:
- AI 提供商: DeepSeek
- API Key:
sk-xxxxxxxxxxxxxxxxxxxxxxxx - Base URL: 留空(使用默认
https://api.deepseek.com) - 模型名称:
deepseek-chat
费用参考:
- 输入: ¥1/百万 tokens
- 输出: ¥2/百万 tokens
- 新用户通常有免费额度
2. SiliconFlow (硅基流动)
特点:
- ✅ 支持多种开源大模型
- ✅ 支持余额查询
- ✅ 国内访问速度快
- ✅ 新用户有免费额度
如何获取 API Key:
- 访问 SiliconFlow 官网
- 注册并登录账号
- 进入 "API Keys" 页面
- 点击 "创建新的 API Key"
- 复制生成的 API Key (以
sk-开头)
配置示例:
- AI 提供商: SiliconFlow
- API Key:
sk-xxxxxxxxxxxxxxxxxxxxxxxx - Base URL: 留空(使用默认
https://api.siliconflow.cn/v1) - 模型名称:
Qwen/Qwen2.5-7B-Instruct或deepseek-ai/DeepSeek-V2.5
推荐模型:
Qwen/Qwen2.5-7B-Instruct- 通义千问,中文能力强deepseek-ai/DeepSeek-V2.5- DeepSeek 模型Qwen/Qwen2.5-72B-Instruct- 更强大的模型(费用更高)
3. OpenAI (兼容接口)
特点:
- ✅ 支持 OpenAI 官方 API
- ✅ 支持兼容 OpenAI API 的第三方服务
- ✅ OpenAI 官方连接可自动使用 Responses API
- ✅ 自定义 Base URL 时继续使用 Chat Completions,兼容中转和第三方服务
- ⚠️ 不支持余额查询
- ⚠️ 国内访问可能需要代理
调用方式说明:当提供商选择 OpenAI、Base URL 使用官方默认地址,且安装的 OpenAI SDK 支持 Responses API 时,系统会自动调用
/v1/responses。如果填写了自定义 Base URL,系统会按兼容性优先原则使用 Chat Completions,不要把第三方兼容服务误当作官方 Responses API。
如何获取 API Key:
方式 1: OpenAI 官方
- 访问 OpenAI Platform
- 注册并登录账号
- 进入 "API Keys" 页面
- 点击 "Create new secret key"
- 复制生成的 API Key (以
sk-开头)
方式 2: 第三方兼容服务
- 使用支持 OpenAI API 格式的第三方服务(如 Azure OpenAI, 各种中转服务等)
- 获取对应服务的 API Key 和 Base URL
配置示例:
- AI 提供商: OpenAI
- API Key:
sk-xxxxxxxxxxxxxxxxxxxxxxxx - Base URL:
https://api.openai.com/v1(官方) 或自定义兼容接口 - 模型名称:
gpt-4-turbo,gpt-4,gpt-3.5-turbo
4. Google Gemini
特点:
- ✅ Google 的多模态 AI 模型
- ✅ 免费额度较高
- ✅ 使用官方 SDK
- ⚠️ 不支持余额查询
- ⚠️ 国内访问需要代理
如何获取 API Key:
- 访问 Google AI Studio
- 使用 Google 账号登录
- 点击 "Get API Key"
- 创建新的 API Key
- 复制生成的 API Key (通常以
AI开头)
配置示例:
- AI 提供商: Google Gemini
- API Key:
AIzaSyxxxxxxxxxxxxxxxxxxxxxxxx - Base URL: 留空(使用官方 SDK)
- 模型名称:
gemini-1.5-flash,gemini-1.5-pro,gemini-2.0-flash-exp
推荐模型:
gemini-1.5-flash- 速度快,适合大部分场景gemini-1.5-pro- 更强大,适合复杂任务gemini-2.0-flash-exp- 实验性最新模型
免费额度:
- Gemini 1.5 Flash: 每分钟 15 次请求
- Gemini 1.5 Pro: 每分钟 2 次请求
⚙️ 在系统中配置 AI
Web UI 配置
登录 Web UI
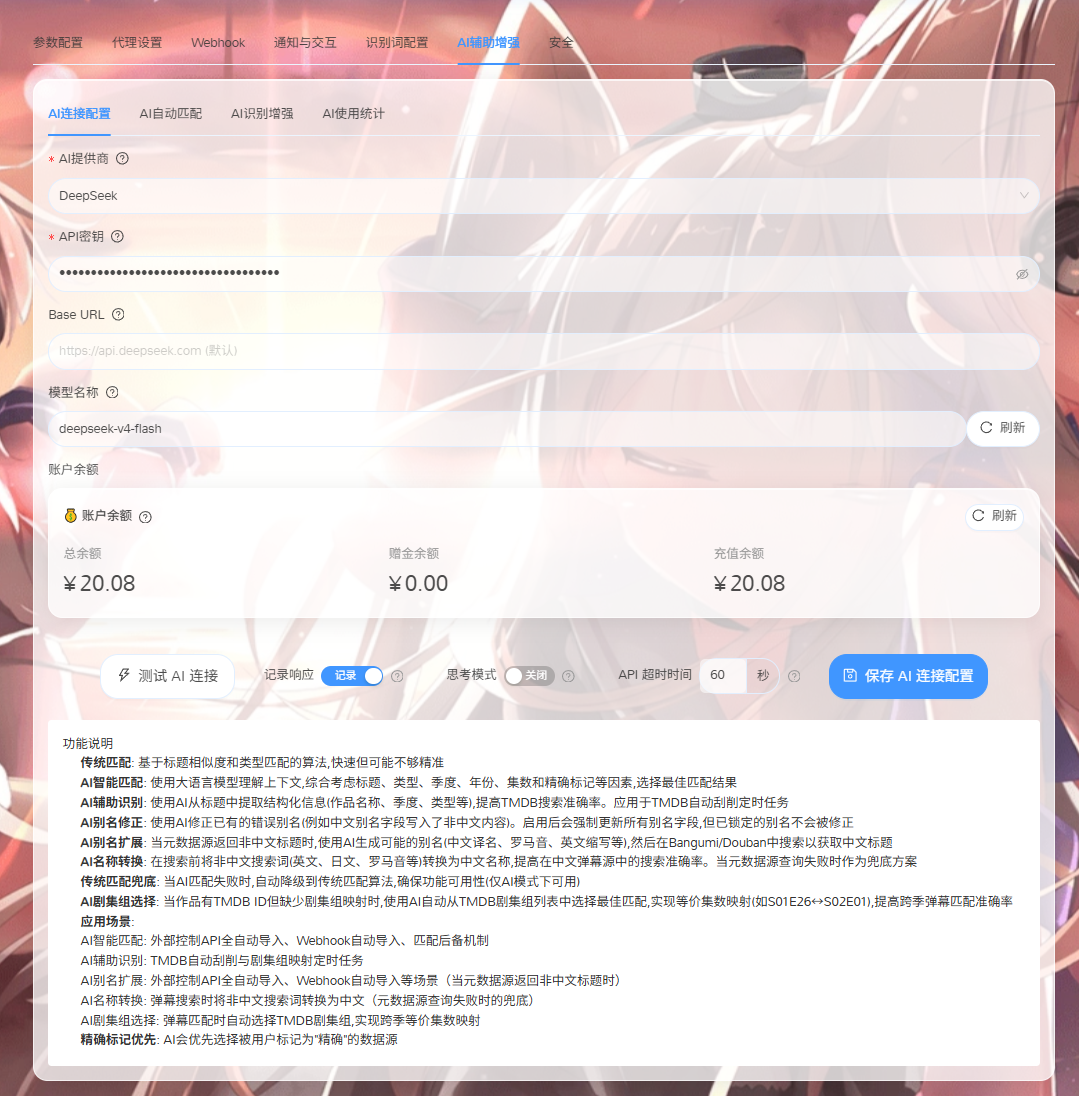
进入 "设置" → "AI辅助增强" → "AI连接配置"
在 "AI 连接配置" 卡片中:
- 选择 AI 提供商
- 填写 API Key
- (可选) 填写 Base URL (通常留空使用默认值)
- 填写 模型名称
点击 "测试 AI 连接" 验证配置
点击 "保存 AI 连接配置"
高级运行参数
以下参数通常位于 AI 辅助增强的高级配置区域;如果当前版本未显示,请以 Web UI 实际提供的配置项为准:
| 配置项 | 默认值 | 作用 |
|---|---|---|
ai_call_timeout | 60 秒 | 单次 AI 请求的超时时间;慢速推理模型可适当调高 |
ai_thinking_enabled | 关闭 | DeepSeek 思考模式开关;启用后可在原始响应日志中记录推理内容 |
ai_log_raw_response | 关闭 | 将 AI 原始响应写入专用日志,便于排查 JSON 或模型输出问题 |
ai_cache_enabled | 开启 | 是否缓存重复的 AI 请求结果 |
ai_cache_ttl | 3600 秒 | AI 响应缓存的有效期 |
日志与隐私
原始响应日志可能包含文件名、作品标题、自定义提示词或第三方接口返回内容。仅在排查问题时短期开启,并注意日志权限、磁盘空间和敏感信息泄露风险。
模型列表与余额
- DeepSeek 和 SiliconFlow 支持通过各自接口查询余额;OpenAI 和 Gemini 不提供统一的余额查询按钮;
- 模型名称建议通过配置页面的刷新按钮从当前 Base URL 获取,避免填写已经下线或无权限使用的模型;
- 自定义 Base URL 的模型列表、模型名称和参数兼容性由第三方服务决定;
- 保存配置后先点击 测试 AI 连接,再启用高频任务中的 AI 功能。
🎯 AI 功能详细说明
1. AI 智能匹配
功能: 当搜索结果有多个相似项时,使用 AI 选择最佳匹配。
启用方式:
- Web UI → "设置" → "AI辅助增强" → "AI 自动匹配"
- 将 "匹配模式" 设置为 "AI 智能匹配"
使用场景:
- 同名作品有多个版本(如电影重拍、不同年份的剧集)
- 搜索结果中有相似但不同的作品
- 需要根据年份、类型等信息精确匹配
自定义提示词:
- 点击 "填充默认提示词" 查看默认提示词
- 可根据需要自定义提示词以优化匹配效果
AI 返回结果通常包含以下信息:
index:选中的候选结果索引;confidence:匹配置信度;reason:选择该结果的理由。
系统会把精确标记源、媒体库中已有的源和识别词命中情况作为上下文提供给 AI,但最终结果仍应结合标题、年份、季度和集数人工确认。AI 调用失败或返回无法解析的 JSON 时,系统会记录失败指标并按对应功能的回退策略继续处理。
AI 调用方式与 JSON 输出
OpenAI 兼容提供商的结构化任务会要求模型返回 JSON:
- OpenAI 官方连接优先使用 Responses API,并从
output_text读取结果; - DeepSeek、SiliconFlow 以及填写了自定义 Base URL 的 OpenAI 连接使用 Chat Completions;
- 系统会尝试从标准 JSON、Markdown 代码块或响应中的完整 JSON 对象提取结果;
- 不建议在提示词中要求额外解释,否则可能增加 JSON 解析失败概率。
2. AI 季度映射
功能: 从元数据源搜索结果中选择正确的季度。
启用方式:
- Web UI → "设置" → "AI辅助增强" → "AI 自动匹配"
- 启用对应场景的 "TMDB 季度映射":
- Webhook TMDB 季度映射
- 匹配后备 TMDB 季度映射
- 全自动导入 TMDB 季度映射
使用场景:
- 多季度剧集匹配
- 季度编号不规范的情况
- 需要从多个搜索结果中选择正确季度
配置选项:
- 季度映射元数据源: 选择用于季度映射的元数据源(TMDB, TVDB, IMDb, Douban, Bangumi)
- AI 季度映射提示词: 自定义提示词以优化季度选择
季度映射采用“算法优先、AI 兜底”的策略:当标题与季度名称或别名的相似度达到阈值时直接采用算法结果;无法确定时才调用 AI。TMDB 剧集组选择也会优先处理明确的 Seasons、播出顺序组和标题季度信息,再使用 AI 选择候选剧集组。
这样可以减少不必要的 API 调用,并降低相似季度之间的误判概率。
3. AI 识别增强
功能: 从文件名中提取结构化信息(标题、季度、集数等)。
启用方式:
- Web UI → "设置" → "AI辅助增强" → "AI 自动匹配"
- 启用 "AI 识别增强"
使用场景:
- 文件名格式不规范
- 文件名包含复杂的标题和季度信息
- 需要从文件名中提取准确的元数据
示例:
- 输入:
[某字幕组] 进击的巨人 最终季 Part 2 - 01 [1080P].mkv - AI 识别: 标题=
进击的巨人, 季度=4, 集数=1
4. AI 别名验证
功能: 验证和分类别名,识别语言类型。
启用方式:
- Web UI → "设置" → "AI辅助增强" → "AI 自动匹配"
- 启用 "AI 别名验证"
使用场景:
- 验证别名是否真正属于该作品
- 识别别名的语言类型(中文/英文/日文/罗马音)
- 过滤无关或错误的别名
5. AI 别名扩展
功能: 生成可能的别名用于搜索。
启用方式:
- Web UI → "设置" → "AI辅助增强" → "AI 自动匹配"
- 启用 "AI 别名扩展"
使用场景:
- 元数据源返回非中文标题
- 需要在中文弹幕源中搜索
- 扩展搜索范围以提高匹配成功率
示例:
- 输入:
Attack on Titan - AI 扩展:
进击的巨人,Shingeki no Kyojin,AOT
💡 最佳实践
1. 选择合适的 AI 提供商
- 个人使用: 推荐 DeepSeek 或 SiliconFlow,性价比高
- 高频使用: 推荐 DeepSeek,费用低且稳定
- 国际用户: 推荐 Gemini,免费额度高
- 企业用户: 推荐 OpenAI,质量最高
2. 合理启用 AI 功能
- 必须启用: AI 智能匹配(核心功能)
- 推荐启用: AI 季度映射(多季度剧集)
- 按需启用: AI 识别增强、别名验证、别名扩展
3. 监控 API 使用
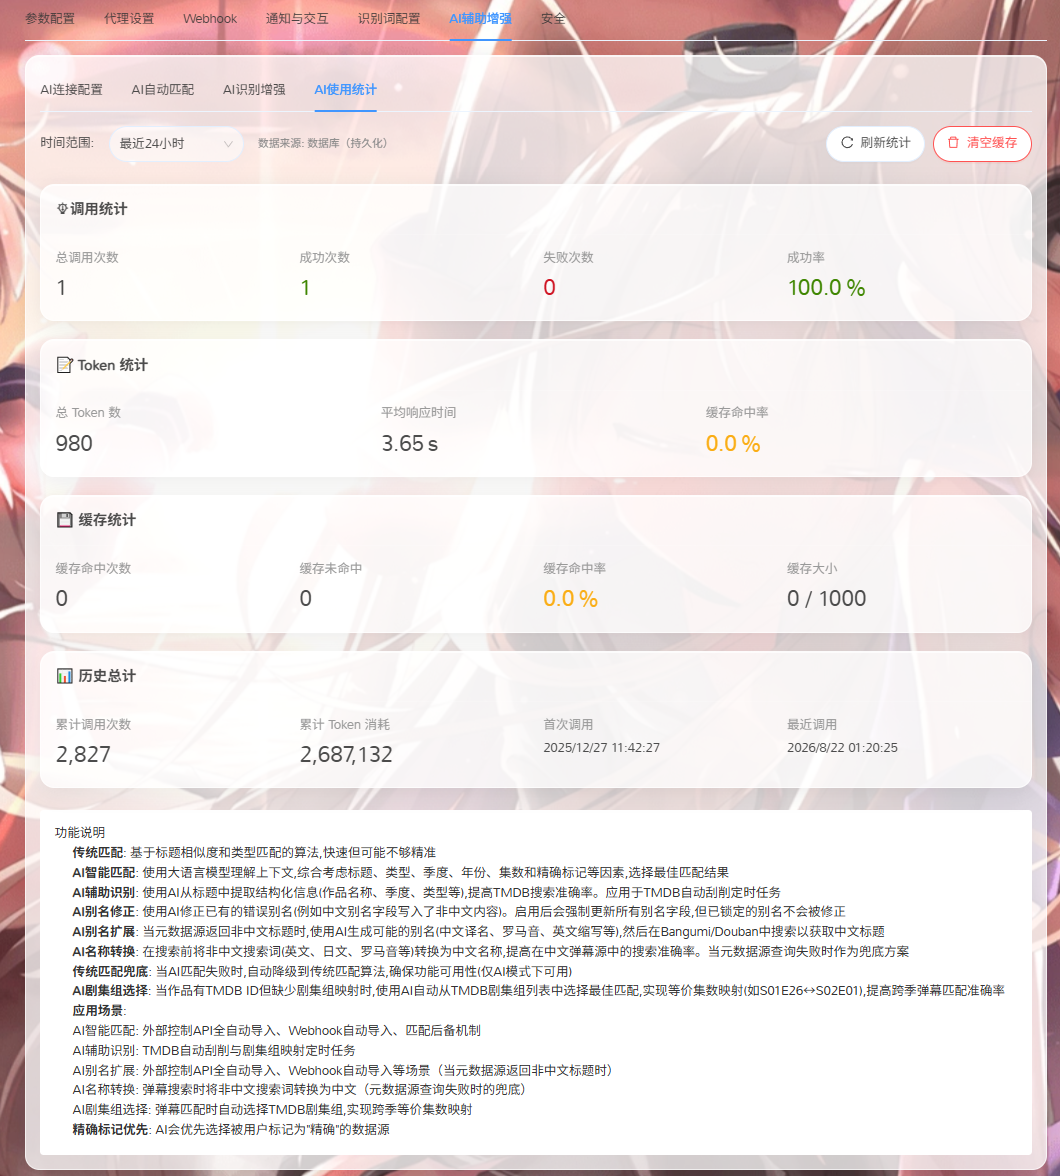
- 定期查看余额(DeepSeek 和 SiliconFlow 支持)
- 启用 "记录响应" 查看 AI 返回的详细信息
- 根据日志优化提示词
4. AI 调用日志与指标
AI 模块会记录调用方法、成功或失败、耗时、Token 数、模型名称和缓存命中情况。出现匹配异常时,建议按以下顺序排查:
- 先确认 AI 连接测试成功,API Key、Base URL 和模型名称正确;
- 再查看请求是否超时或被服务商拒绝;
- 开启原始响应日志,检查模型是否返回了合法 JSON;
- 对重复请求可暂时关闭缓存,避免旧结果干扰定位;
- 问题确认后关闭详细日志,并清理包含敏感内容的日志文件。
缓存命中可以减少费用和响应时间,但缓存结果可能在提示词、候选结果或元数据发生变化前继续生效。调整提示词或模型后,建议等待缓存过期或清理对应缓存。
5. 参数兼容注意事项
季度匹配、正则生成等纯文本任务会使用短输出限制;结构化任务使用 JSON 输出模式。系统会根据提供商选择兼容的 token 参数:OpenAI 官方新模型使用 max_completion_tokens,DeepSeek 和 SiliconFlow 等第三方兼容接口使用 max_tokens。一般不需要手动修改这些参数。
❓ 常见问题
Q: AI 功能必须配置吗?
A: 不是必须的。AI 功能是可选的增强功能,不配置也可以正常使用弹幕服务。
Q: 哪个 AI 提供商最便宜?
A: DeepSeek 性价比最高,输入 ¥1/百万 tokens,输出 ¥2/百万 tokens。
Q: AI 功能会消耗很多费用吗?
A: 不会。AI 功能仅在匹配时调用,每次调用消耗的 tokens 很少,通常每月费用不超过几元。
Q: 测试 AI 连接失败怎么办?
A: 请检查:
- API Key 是否正确(没有多余空格)
- 网络是否能访问 AI 服务(国外服务可能需要代理)
- 模型名称是否正确
- 查看系统日志中的详细错误信息
Q: OpenAI Responses API 调用失败怎么办?
A: 确认提供商为 OpenAI、Base URL 使用官方默认地址,并且 OpenAI SDK 版本支持 Responses API。填写第三方兼容服务地址时,系统会改用 Chat Completions;此时应以该服务的兼容参数和模型列表为准。
Q: AI 请求经常超时怎么办?
A: 先检查代理、网络和服务商状态;如果模型本身响应较慢,可将 ai_call_timeout 从默认 60 秒适当提高,但不建议无限增大,否则任务会长时间占用资源。
Q: 开启思考模式后看不到推理内容怎么办?
A: ai_thinking_enabled 目前主要影响 DeepSeek,并且只有同时开启原始响应日志时才会记录 reasoning 内容。日志可能包含敏感信息,排查完成后应关闭该选项。
Q: 可以同时使用多个 AI 提供商吗?
A: 不可以。系统同时只能配置一个 AI 提供商。
Q: Gemini 在国内无法访问怎么办?
A: 需要配置代理。在 "设置" → "代理设置" 中配置全局代理,所有 AI 请求都会通过代理。